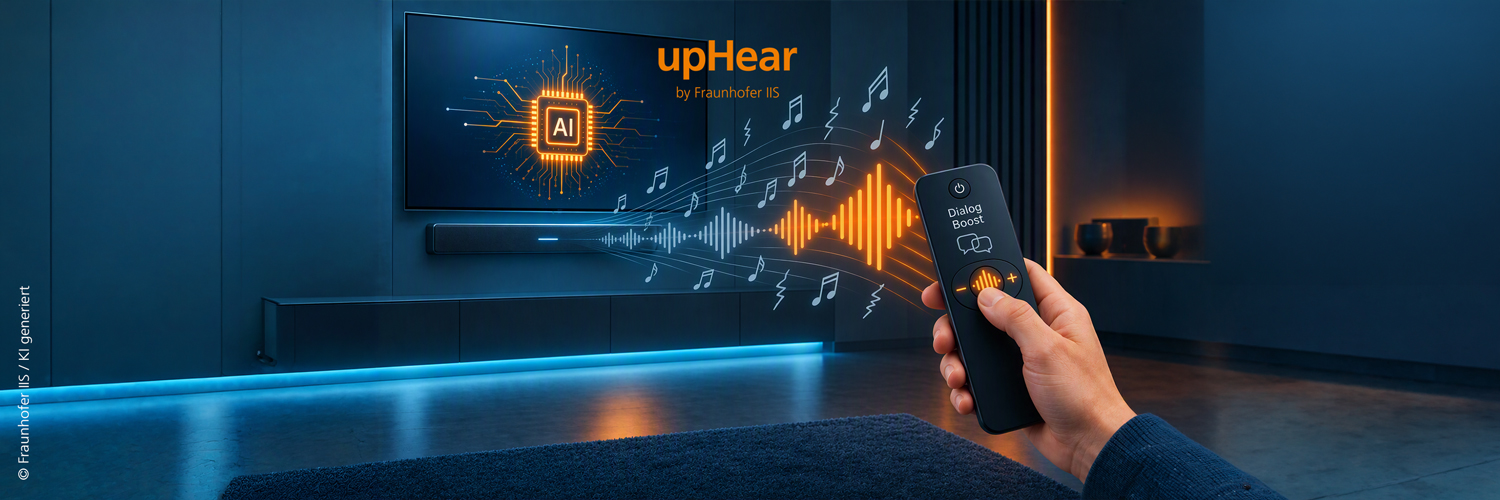
Fraunhofer IIS正在扩展其 upHear 产品系列,推出了一项旨在实时提升语音清晰度的新技术——upHear Live Dialog Boost。该模块利用基于人工智能的对话分离技术来增强语音内容,特别适用于对延迟要求极高且资源占用限制严格的应用场景。
从增益控制到基于人工智能的对话分离
在家庭娱乐领域,清晰的对白是用户最常提出的需求之一。许多观众反映,在观看电影或电视节目时,往往难以听清其中的对白,尤其是在背景音乐或音效过于突出的情况下。传统的音频处理技术存在局限性:简单的增益调节往往会连同噪声一起放大;而常规的数字信号处理(DSP)算法则容易导致音色失真,或破坏立体声声场。
Fraunhofer IIS以其 MPEG-H Dialog+ 技术而闻名;该技术为专业制作与广播领域中的对话增强树立了行业标杆。upHear Live Dialog Boost 正是基于这一深厚的技术积淀而开发;Dialog+ 与 upHear Live Dialog Boost 虽都旨在提升语音清晰度,但在音频链路中却发挥着截然不同的作用,且在实现对话增强时所采用的技术路径也各不相同。
upHear Live Dialog Boost 将对话增强技术与尖端的低资源 AI 建模相结合:与传统的数字信号处理(DSP)方法不同,它能够在复杂的音频场景中从语义层面识别并分离出语音,在提升清晰度的同时,完整保留原始混音效果。upHear Live Dialog Boost 可将此功能应用于消费类设备的嵌入式处理器中,从而实现基于 AI 的实时增强,且仅需极低的延迟和内存资源。
upHear Live Dialog Boost 的主要特点包括:
- 在复杂的音轨环境中,依然能实现稳健的对话分离效果
- 完整保留原始的空间音频声像
- 低延迟实时处理,满足严苛的音画同步(口型同步)要求
- 轻量化 AI 模型,经优化后内存占用极低
- 算力需求适中,无需依赖专有的神经处理架构,可在通用 CPU 上运行——尤其适用于中端及入门级设备。
upHear Live Dialog Boost 可无缝集成至现有的 upHear 生态系统中,并能针对各类硬件平台以及基于云端或服务器的环境进行适配。
针对嵌入式音频处理设计,该程序库也适用于各类成熟的 DSP 集成平台,从而加速在现有信号流程设计工作流程中的评估、实现与调试过程。
设备端实时语音增强
upHear Live Dialog Boost 是一款轻量级解决方案,能够适应多种部署环境:
它可应用于各类终端播放设备,包括电视、机顶盒、条形音箱、流媒体播放棒、智能音箱及移动设备。除了音频设备外,该方案还可部署于其他对延迟要求极高的实时应用与服务场景中。
upHear Live Dialog Boost的开发汲取了Fraunhofer IIS多个研究领域的专业知识——从音频系统设计和空间处理,到基于人工智能的语音增强,再到低复杂度的嵌入式实现。
upHear Live Dialog Boost 体现了 upHear 系列技术的核心理念:将高标准的感知音质与边缘设备层面的处理技术专长相结合。upHear 处理模块由音频及人工智能数字信号处理(AI DSP)领域的专家共同开发,旨在助力设备制造商打造业界领先的音频产品。
This post is also available in:


